支持向量机原ç�?/p>
支持向量机于
1995
年正式发表,由于在文本分类任务中显示出卓越性能ï¼?/p>
很快成为机器学习的主流技术,并直接掀起了“统计学习”在
2000
年前后的é«?/p>
潮。但实际上,支持向量机的概念早在
20
世纪六十年代就已经出现,统计学习
理论åœ?/p>
70
年代就已成型ã€?/p>
对核函数的研究更早,
Mercer
定理可追溯到
1909
年,
RKHS
则在
40
年代就已被研究,但在统计学习兴起后,核技巧才真正成为机器å?/p>
习的通用基本技术ã€?/p>
支持向量æœ?/p>
(support
vector
machine)
是一种分类算法,通过寻求结构化风
险最小来提高学习机泛化能力,
实现经验风险和置信范围的最小化ï¼?/p>
从而达到在
统计样本量较少的情况下,
亦能获得良好统计规律的目的ã€?/p>
通俗来讲ï¼?/p>
它是一ç§?/p>
二类分类模型ï¼?/p>
其基本模型定义为特征空间上的间隔最大的线性分类器ï¼?/p>
即支æŒ?/p>
向量机的学习策略便是间隔最大化,最终可转化为一个凸二次规划问题的求解ã€?/p>
支持向量机是针对二分类任务设计的ï¼?/p>
对多分类任务要进行专门的推广ï¼?/p>
对带ç»?/p>
构输出的任务也已有相应的算法ã€?/p>
核函数直接决定了支持向量机于核方法的最终性能ï¼?/p>
但遗憾的是,
核函数的
选择是一个未决问题ã€?/p>
多核学习使用多个核函数并通过学习获得其最优凸组合ä½?/p>
为最终的核函数,这实际上是在借助集成学习机制ã€?/p>
替代损失函数在机器学习中被广泛使用ã€?/p>
但是ï¼?/p>
通过求解替代损失函数得到
的是否仍是原问题的解?这在理论上称为替代损失çš?/p>
“一致性â€?/p>
问题ã€?/p>
给出了基
于替代损失进行经验风险最小化的一致性充要条件,
证明了几种常见凸替代损失
函数的一致性ã€?/p>
支持向量机的求解通常是借助于凸优化技术ã€?/p>
如何提高效率ï¼?/p>
ä½?/p>
SVM
能适用
于大规模数据一直是研究重点ã€?/p>
对线性核
SVM
已有很多成果ï¼?/p>
例如基于割平面法
çš?/p>
SVM
具有线性复杂度ï¼?/p>
基于随机梯度下降çš?/p>
Pegasos
速度甚至更快ï¼?/p>
而坐标下
降法则在稀疏数据上有很高的效率ã€?/p>
非线性核
SVM
的时间复杂度在理论上不可èƒ?/p>
低于
O
ï¼?/p>
m
²ï¼?/p>
,因此研究重点是设计快速近似算法,如基于采样的
CVM
、基于低ç§?/p>
逼近çš?/p>
Nystr
ö
m
方法ã€?/p>
基于随机傅里叶特征的方法等ã€?/p>
最近有研究显示ï¼?/p>
当核çŸ?/p>
阵特征值有很大差别时,
Nystr
ö
m
方法往往优于随机傅里叶特征方法ã€?/p>
具体原理ï¼?/p>
1.
�/p>
n
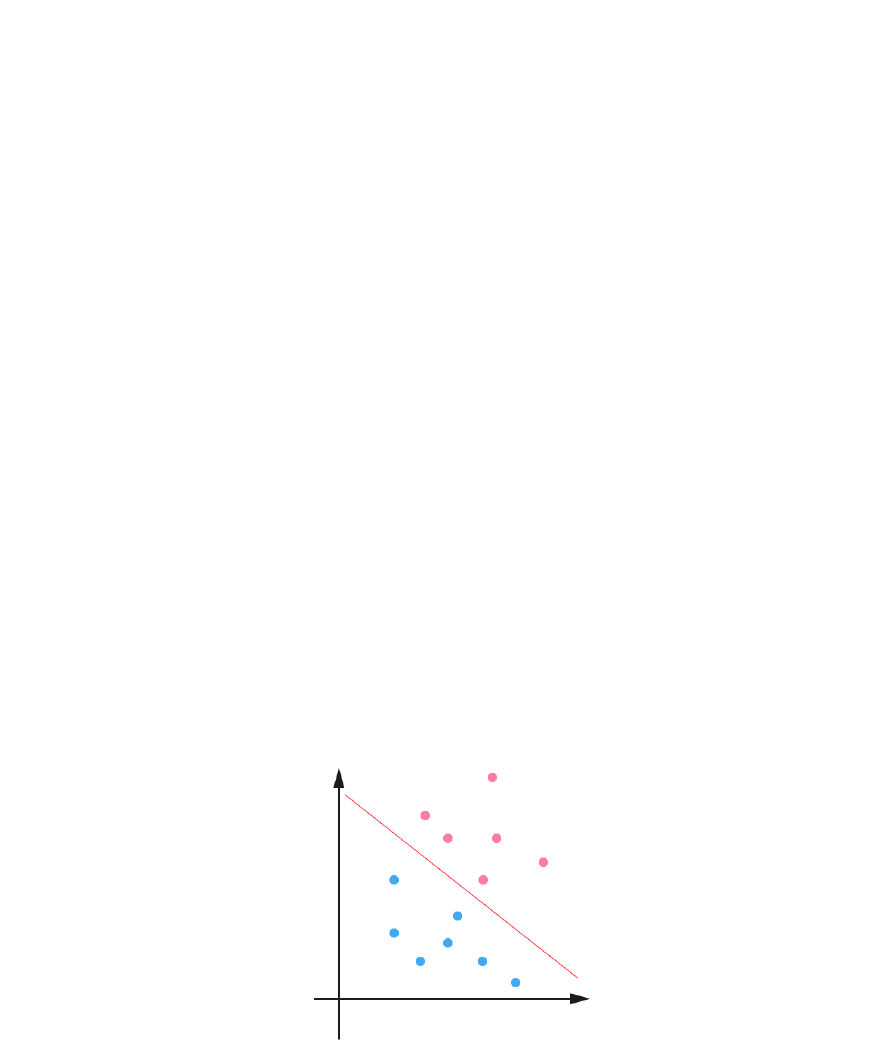
维空间中找到一个分类超平面ï¼?/p>
将空间上的点分类ã€?/p>
如下图是线性分类的
例子ã€?/p>